AI-ready begint niet bij een tool, maar bij je datafundament
Veel organisaties kennen het: de directeur vraagt naar de marge op een productgroep, en er verschijnen drie rapporten met drie verschillende antwoorden. Of sales meldt 120 nieuwe klanten dit kwartaal, terwijl finance op 94 uitkomt. Allebei hebben ze gelijk, maar hanteren een andere definitie van 'klant'.
Zulke verschillen zijn al vervelend in een maandrapportage. Zodra je met AI aan de slag gaat, worden zulke verschillen een probleem.
AI staat hoog op de agenda, maar in de praktijk valt de opbrengst tegen. Niet omdat AI niet werkt, maar omdat de basis nog niet op orde is.
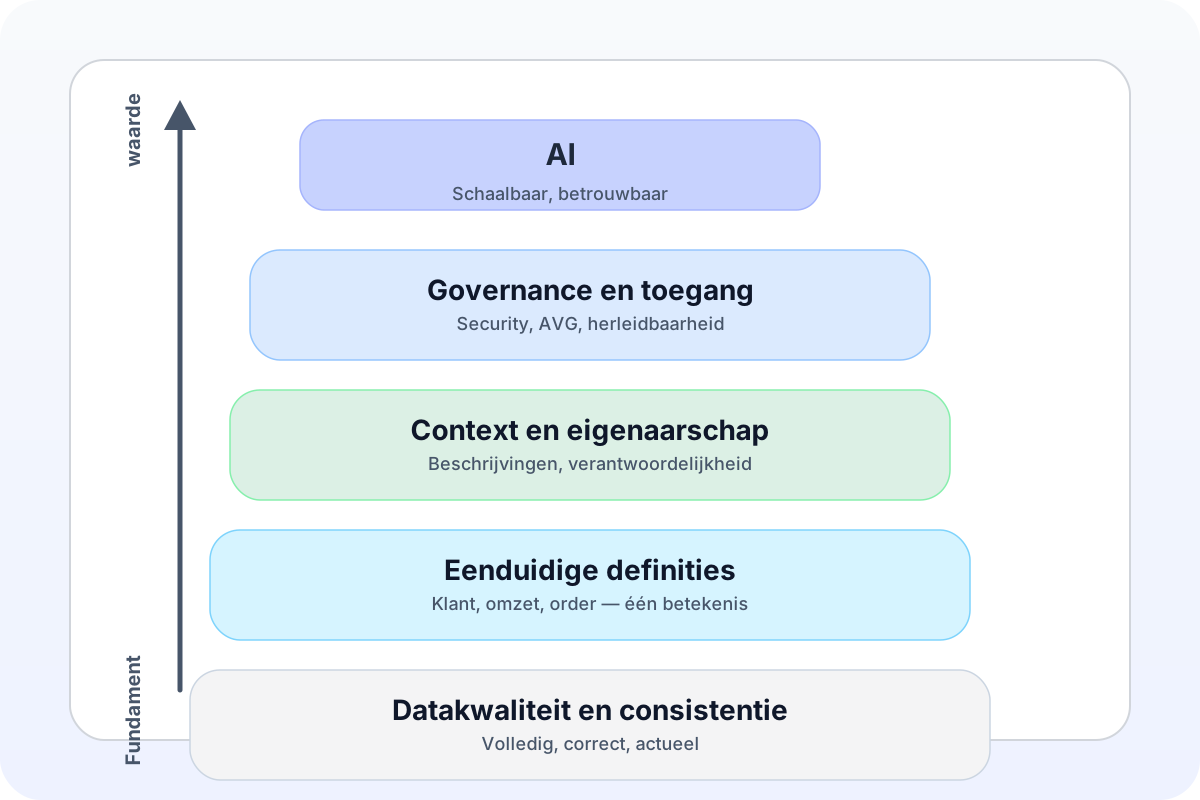
AI gebruikt data zoals die nu binnen het bedrijf vastligt met alle definities, aannames, hiaten en tegenstrijdigheden die daarbij horen. Is die data versnipperd, of verschilt de betekenis per afdeling, dan levert AI geen scherpe inzichten op maar vooral veel verwarring of onlogische uitkomsten op.
Bij een bedrijf van 25 man ziet dat er anders uit dan bij een bedrijf van 200. De kleinere onderneming worstelt met data verspreid over Exact, een webshop, een CRM en een paar cruciale Excel-bestanden op iemands bureaublad. De grotere organisatie heeft wel BI-tooling, maar er is door de jaren heen een wildgroei ontstaan: tientallen rapporten, meerdere definities per KPI, en niemand die nog weet welk getal klopt.
Verschillende grootte van bedrijven, maar ze hebben hetzelfde probleem, namelijk een ontbrekend datafundament. Met dezelfde gevolgen:
- – rapporten met verschillende uitkomsten op dezelfde vraag;
- – onduidelijkheid over welke cijfers je kunt vertrouwen;
- – data die technisch beschikbaar is, maar inhoudelijk niet begrepen wordt;
- – beperkt vertrouwen in analyses en dus beslissingen die vooral op 'het onderbuikgevoel' worden genomen.
AI lost de bovenstaande punten niet op, maar het maakt deze problemen wel sneller zichtbaar.
Wat is een goed datafundament?
Een datafundament is meer dan een datawarehouse of een BI-tool. Het is de combinatie van techniek, afspraken en context die ervoor zorgt dat data betrouwbaar en bruikbaar is, voor zowel analyses en rapportages die door werknemers worden gebruikt en die gelden als input voor AI.
Concreet betekent dat: eenduidige definities van kernbegrippen, consistente brondata, duidelijke samenhang tussen systemen, vast eigenaarschap, herleidbaarheid van cijfers, en toegangsrechten die logisch zijn ingericht. Pas als deze basis staat, kan AI echt wat toevoegen.
Wanneer is data AI-ready?
AI-ready betekent niet: zoveel mogelijk data verzamelen. Het betekent: data begrijpelijk, betrouwbaar en contextueel maken. In de praktijk vraagt dat om een paar concrete stappen:
- 1. Standaardiseer definities: wat is een 'actieve klant'? Voor sales is dat wie dit jaar iets kocht, voor finance wie een openstaande factuur heeft, voor marketing wie de nieuwsbrief nog opent. Zonder duidelijke afspraak zal AI al deze interpretaties door elkaar halen en overtuigend antwoorden geven die onderling tegenstrijdig zijn.
- 2. Verhoog datakwaliteit: AI is zo goed als de data die je erin stopt. Ontbrekende postcodes, dubbele klantrecords, orderregels zonder productcode. Dit lijkt niet zo belangrijk als je niet in een datateam werkt, maar juist deze details worden heel belangrijk naarmate je meer datagedreven wil werken en vooral AI wil inzetten bij analyses. Datakwaliteit is geen eenmalig project, maar iets dat hoort bij hoe je data dagelijks verzamelt en onderhoudt.
- 3. Voeg context toe: een kolomnaam als KL_OMZ_Q3 zegt een collega misschien iets, maar AI heeft uitleg nodig. Door beschrijvingen, synoniemen en bedrijfsdefinities toe te voegen aan je data, wordt die ook voor AI-toepassingen interpreteerbaar. In Power BI kan dat bijvoorbeeld rechtstreeks in het semantisch model.
- 4. Regel eigenaarschap: wie beheert de definitie van 'omzet'? Wie bepaalt wanneer die mag veranderen? Bij 30 man kan dat een persoon zijn; bij 200 man vraagt het om afspraken tussen afdelingen. Zonder eigenaarschap blijft data versnipperd.
- 5. Zorg voor herleidbaarheid: AI-uitkomsten moeten uitlegbaar zijn. Zeker als je er beslissingen op baseert, of als klanten of toezichthouders kritisch meekijken, moet altijd duidelijk zijn waar een cijfer vandaan komt.
- 6. Regel toegang en AVG bewust: AI heeft toegang nodig tot data, maar niet tot alles, en niet op elke locatie. Voor Nederlandse organisaties is het belangrijk te weten waar data verwerkt wordt zodra je AI inzet. Veel publieke AI-diensten sturen data naar servers buiten de EU. Wie dit vooraf regelt, bijvoorbeeld via EU-gehoste AI-infrastructuur voorkomt dat een veelbelovende pilot op een compliance-muur stukloopt.
Begin bij de basis, dan volgt AI vanzelf.
Organisaties die nu echte stappen zetten met AI, beginnen niet bij tools of experimenten. Ze versterken eerst hun datafundament. Dat is minder spectaculair, maar beslissend voor succes.
Zonder stevig fundament blijft AI hangen in losse pilots en groeit het wantrouwen in uitkomsten. Met een goed fundament worden inzichten consistenter, groeit vertrouwen in data, en kan AI gecontroleerd worden ingezet.
AI-ready begint niet bij een tool, maar bij je datafundament.
Bij Deux2Qonnect starten we daarom altijd met een eerlijke blik op het fundament, voordat we over AI-toepassingen praten. Niet omdat AI niet belangrijk is, maar juist omdat het dat wel is.
Deux2Qonnect · Data, BI & AI voor het MKB · deux2qonnect.nl